Ce que les moteurs de réponse font au trafic des médias
Les moteurs de réponse ne prennent pas du trafic aux médias de façon uniforme. Ils absorbent d'abord les visites de vérification rapide, celles qui rapportaient déjà le moins, tout en fragilisant le modèle publicitaire au volume.
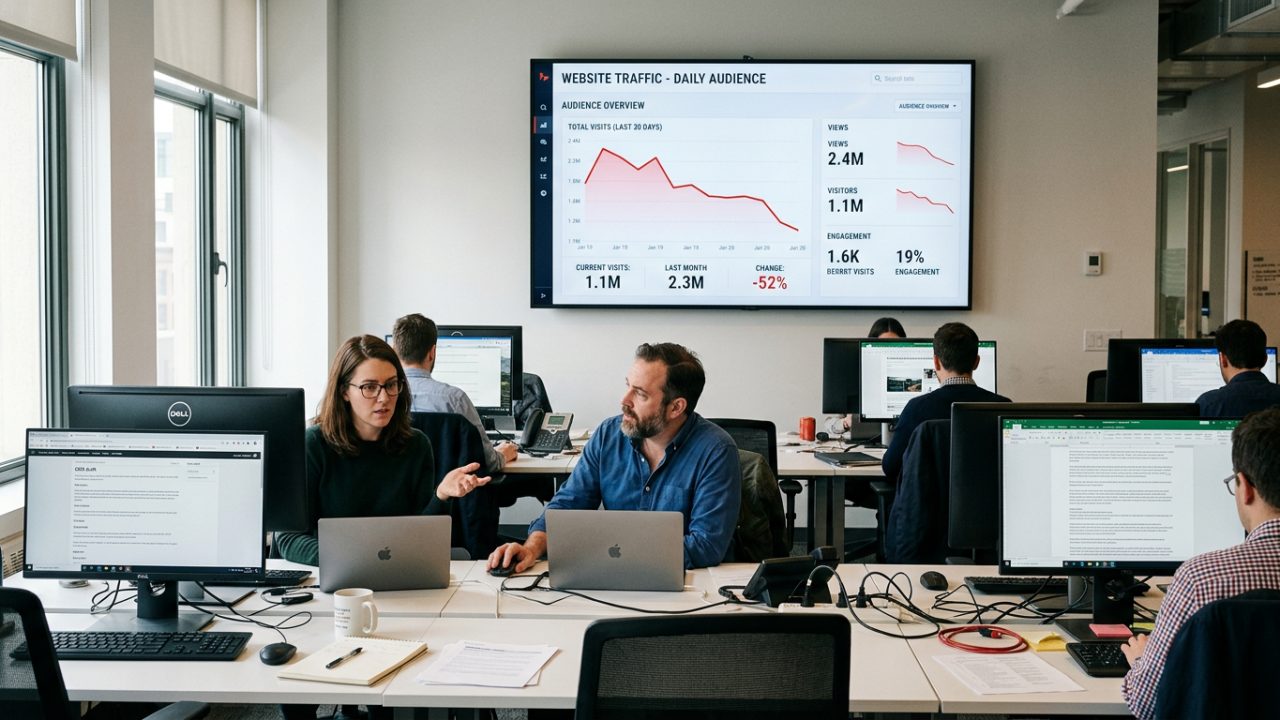
La conversation publique sur le sujet oppose deux caricatures : la fin de la presse en ligne d'un côté, le non-événement de l'autre. Les tableaux de bord des rédactions racontent quelque chose de plus précis, et de plus inquiétant à moyen terme.
Quelles visites disparaissent
Ce sont les visites de vérification. Quelle est la capacité du Stade de France, en quelle année a eu lieu tel événement, comment s'écrit tel nom. Un utilisateur qui obtient sa réponse dans un résumé ne clique plus.
Ces visites avaient une caractéristique connue de tous les éditeurs : un temps de session très court, un taux de rebond proche de 100 %, une valeur publicitaire faible. Elles gonflaient les statistiques sans nourrir le modèle.
Leur disparition fait donc moins de dégâts en revenus qu'en volume affiché. Le problème est ailleurs : une partie des tarifs publicitaires et des positions de négociation se construit sur ce volume.
Ce qui reste, et ce que cela vaut
Le trafic qui subsiste vient de lecteurs qui voulaient l'article, pas l'information. Ils arrivent par la marque, par une newsletter, par un réseau, ou parce que le résumé ne leur a pas suffi.
Ce trafic se comporte mieux sur tous les indicateurs : durée, pages vues, abonnement, retour. Il est moins nombreux et vaut plus par visite.
La conclusion pratique déplaît, mais elle est cohérente : un média dont le modèle reposait sur le volume indifférencié est plus exposé qu'un média dont le modèle repose sur une relation. Les moteurs de réponse accélèrent une transition déjà engagée, ils ne la créent pas.
Le cas particulier de l'actualité chaude
Les blocs génératifs se déclenchent moins sur l'actualité récente, où les moteurs restent prudents. Google applique des restrictions explicites sur les sujets sensibles, comme le rappelle notre dossier sur les AI Overviews en France.
Cela protège partiellement les pure players d'information, et beaucoup moins les sites de contenu explicatif, de service ou de guides pratiques, qui constituent une part importante des revenus de nombreux groupes.
Le terrain juridique
L'article 15 de la directive européenne de 2019 a créé un droit voisin pour les éditeurs de presse, transposé en France la même année. Il a d'abord servi dans les négociations avec les moteurs de recherche sur l'affichage d'extraits.
Son application aux usages génératifs, entraînement et réponse, a nourri plusieurs procédures devant l'Autorité de la concurrence. Le point de droit central est le même que dans le débat sur les extraits : un résumé produit à partir d'un article relève-t-il d'un usage soumis à autorisation, et à quelle rémunération.
Les accords signés entre éditeurs et fournisseurs de modèles se multiplient, avec une conséquence structurelle : les grands groupes obtiennent des contrats, les petits éditeurs et les indépendants n'ont personne avec qui négocier.
Les réponses qui tiennent
Trois directions se dégagent chez les éditeurs qui s'en sortent le mieux.
Développer ce qu'aucun moteur n'intermédie : newsletter avec une vraie ligne éditoriale, application, événements, communauté, abonnement. Le point commun est l'accès direct au lecteur.
Produire ce qu'un résumé ne remplace pas : enquête, donnée propriétaire, terrain, point de vue signé. Un résumé restitue des faits, pas un travail original.
Mesurer autrement. Compter les citations dans les moteurs de réponse à côté des sessions, parce qu'une marque citée sans clic n'apparaît nulle part dans l'analytics. C'est l'objet du baromètre de la citation IA que nous publions chaque mois.
Ce qu'un éditeur peut faire dès ce trimestre
Trois chantiers, du moins coûteux au plus engageant, qui ne supposent aucun accord avec un fournisseur de modèles.
Trier ses archives par exposition. Toutes les pages ne sont pas menacées de la même façon. Les contenus explicatifs génériques, les définitions et les listes de conseils sont les premiers absorbés. Les enquêtes, les données propriétaires et les papiers signés ne le sont pas. Ce tri se fait avec Search Console, en isolant les URL dont le taux de clic s'effondre à position constante. Il donne une liste de pages à fusionner, à enrichir ou à retirer, plutôt qu'un sentiment diffus de déclin.
Rendre les auteurs identifiables. Une page par signataire, reliée à des profils externes vérifiables, et une date visible sur chaque article. Un moteur qui doit trancher entre deux versions d'un fait s'appuie sur ces signaux, et un média qui les néglige se fait citer moins souvent que des sites bien moins sérieux.
Ouvrir un canal direct qui ne dépend d'aucun intermédiaire. Une newsletter avec une ligne éditoriale propre, pas une reprise automatique du flux RSS. C'est le seul actif de cette liste que ni un moteur de recherche ni un moteur de réponse ne peut s'intercaler.
Ce qui ne réglera rien
Bloquer les robots d'IA en bloc, d'abord. La décision se prend agent par agent, et bloquer les robots de recherche revient à disparaître des réponses tout en restant absent des accords de licence. Le détail est dans notre guide sur le blocage de GPTBot.
Produire davantage, ensuite. Le volume était une réponse quand la concurrence portait sur l'occupation de la page de résultats. Il n'en est plus une quand la sélection se fait sur trois à cinq sources.
Attendre un accord collectif, enfin. Les grands groupes négocient, les autres n'ont pas d'interlocuteur, et le calendrier des procédures se compte en années. Le travail décrit plus haut se mène sans attendre.
Sources
- Directive européenne 2019/790 sur le droit d'auteur, article 15
- Autorité de la concurrence, décisions relatives aux droits voisins de la presse
Léa
Léa traite pour aifluence la façon dont l'IA redistribue la visibilité des marques, des médias et des créateurs.