Bloquer GPTBot dans robots.txt : protection ou perte de visibilité ?
Bloquer GPTBot empêche l'utilisation de vos contenus pour l'entraînement des modèles d'OpenAI. Cela n'empêche pas ChatGPT de vous citer, à condition de ne pas bloquer en même temps OAI-SearchBot, ce que font la plupart des sites par erreur.
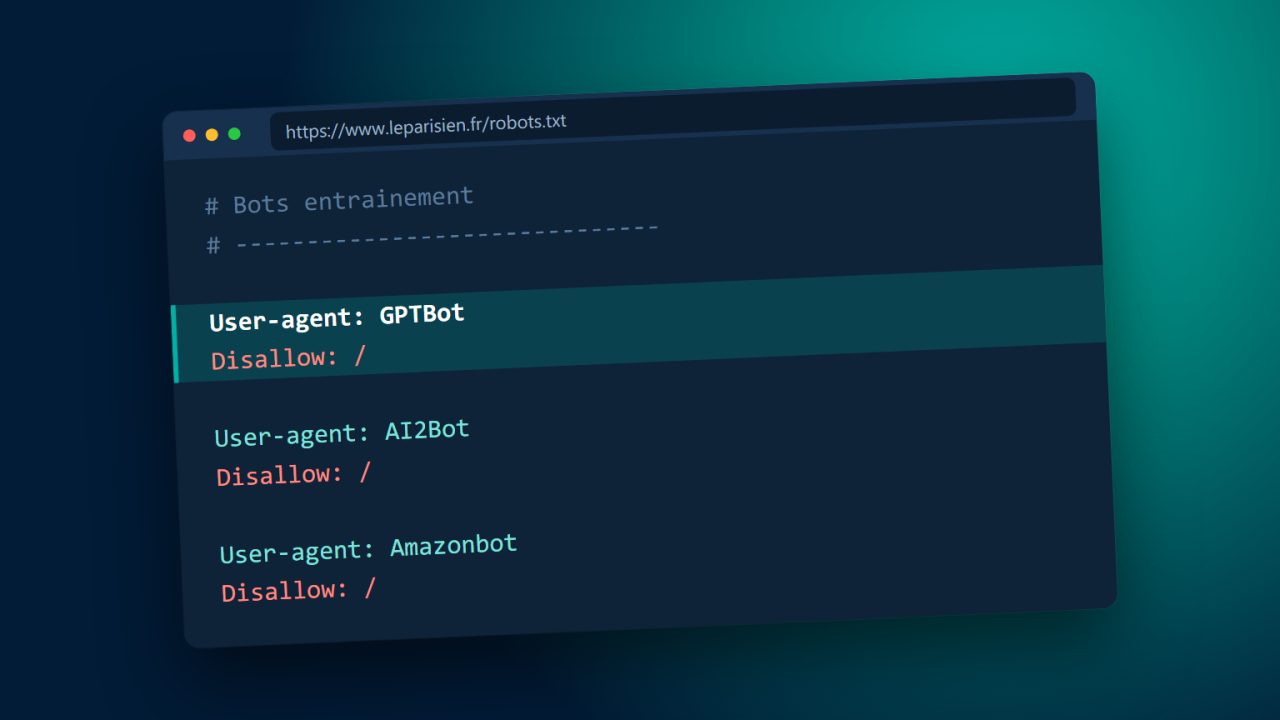
En août 2023, OpenAI publie la documentation de GPTBot et propose aux éditeurs de le bloquer. Des milliers de sites le font en quelques semaines. Trois ans plus tard, une grande partie de ces blocages est toujours en place, et une bonne moitié ne fait pas ce que leurs auteurs croyaient.
Les trois robots d'OpenAI, et ce que chacun fait
GPTBot collecte des pages pour l'entraînement des modèles. Le bloquer signifie que vos contenus ne serviront pas à entraîner les futures versions. Cela n'a aucun effet sur la capacité de ChatGPT à vous citer aujourd'hui.
OAI-SearchBot alimente la fonction de recherche. C'est lui qui permet à ChatGPT de récupérer votre page au moment où un utilisateur pose une question, et d'afficher un lien vers vous. Le bloquer revient à disparaître des réponses citées.
ChatGPT-User intervient quand un utilisateur demande explicitement à consulter une URL. Le bloquer empêche un lecteur d'ouvrir votre page depuis la conversation.
Ces trois robots sont indépendants. Les traiter comme un bloc est l'erreur la plus répandue.
Ce que vous décidez vraiment en bloquant
Bloquer GPTBot est une décision sur la propriété intellectuelle : vous refusez que vos contenus nourrissent un modèle commercial sans contrepartie. La position est défendable, et plusieurs groupes de presse français l'ont retenue en attendant des accords de licence.
Bloquer OAI-SearchBot est une décision de distribution : vous renoncez à apparaître dans les réponses. C'est rarement ce que voulait l'éditeur, et c'est pourtant fréquent, parce que beaucoup de directives ont été recopiées d'un site à l'autre sans distinguer les robots.
La configuration qui correspond au choix le plus courant
Refuser l'entraînement, accepter la citation :
User-agent: GPTBot
Disallow: /
User-agent : OAI-SearchBot<br> Allow : /
User-agent : ChatGPT-User<br> Allow : /<br> ```
Accepter les deux, ce qui est le choix logique pour un site dont l'objectif est la visibilité :
User-agent: GPTBot
Allow: /
User-agent : OAI-SearchBot<br> Allow : /<br> ```
Un point technique souvent oublié : les directives les plus spécifiques l'emportent. Un User-agent : * suivi d'un Disallow : / ne s'applique pas à un robot qui dispose de son propre bloc.
Ce que le robots.txt ne fait pas
Il ne protège rien juridiquement. Le protocole d'exclusion des robots, formalisé par la RFC 9309 en 2022, est une convention respectée par les acteurs qui le souhaitent. Un robot peut l'ignorer sans conséquence technique.
Il n'efface pas ce qui a déjà été collecté. Bloquer GPTBot aujourd'hui n'enlève rien des corpus existants.
Il n'empêche pas les mentions. Un modèle peut citer votre marque à partir de ce que d'autres sites écrivent sur vous, sans jamais avoir lu vos pages.
Pour une opposition qui a une portée juridique, le terrain est ailleurs : conditions générales d'utilisation, droit voisin, opposition à la fouille de textes et de données au sens de la directive européenne de 2019.
Comment vérifier votre situation en cinq minutes
Ouvrez votresite.fr/robots.txt et cherchez GPTBot, OAI-SearchBot, PerplexityBot, ClaudeBot et Google-Extended. Si aucun n'apparaît et que le bloc générique autorise l'exploration, tout va bien. Ce que fait chacun de ces agents est détaillé dans notre liste des robots d'IA.
Si un blocage existe, la seule question qui compte est de savoir qui l'a posé et pourquoi. Un blocage assumé se garde. Un blocage hérité d'un plugin, d'une agence précédente ou d'une décision de 2023 jamais réexaminée mérite un arbitrage explicite.
Ce site autorise explicitement l'ensemble de ces robots, et le dit dans son propre fichier. Être cité est la raison d'être d'un média.
Vérifier ensuite ce que les robots font réellement
Le fichier robots.txt dit ce que vous autorisez. Il ne dit pas ce qui se passe. Pour cela, il n'existe qu'une source fiable, vos journaux serveur.
Ils répondent à trois questions qu'aucun outil externe ne sait traiter. Quels robots viennent réellement sur le domaine, et à quelle fréquence. Quelles URL ils explorent, ce qui révèle souvent qu'ils passent leur temps sur des pages sans intérêt. Et quels codes de réponse ils reçoivent, un robot qui collectionne les 404 et les 500 réduisant de lui-même son rythme de passage. La méthode complète est dans notre guide sur l'analyse de logs.
Une précaution s'impose à la lecture : le nom d'agent déclaré ne prouve rien. N'importe quel script peut se présenter comme GPTBot. La vérification passe par une résolution DNS inverse de l'adresse IP, puis une résolution directe du nom obtenu, et par les plages d'adresses que les éditeurs publient. Les robots d'aspiration qui se déguisent en robots officiels sont assez nombreux pour fausser un comptage.
Le cas particulier des sites à accès payant
Un site dont les contenus sont derrière un abonnement se pose une question différente : ses pages sont vues par les robots dans une version tronquée, celle que voit un visiteur non connecté.
Deux erreurs se rencontrent souvent. Servir aux robots la version complète alors que les lecteurs voient un extrait relève du cloaking et expose à une sanction dans la recherche classique. Bloquer tous les robots, à l'inverse, revient à disparaître aussi des résultats organiques, la partie qui ramène les abonnés.
La position tenable consiste à laisser les robots voir ce que voit un lecteur non abonné, à baliser correctement le contenu payant avec la propriété isAccessibleForFree, et à traiter séparément la question de l'entraînement, qui relève d'une négociation de licence et non d'un fichier texte.
Sources
- OpenAI, documentation officielle des robots d'exploration
- Spécification du protocole d'exclusion des robots, RFC 9309
Yannis
Yannis suit le GEO pour aifluence : robots des moteurs de réponse, extraction, mesure de la citation.