Le fond du sujet
Comment l'IA redistribue la visibilité
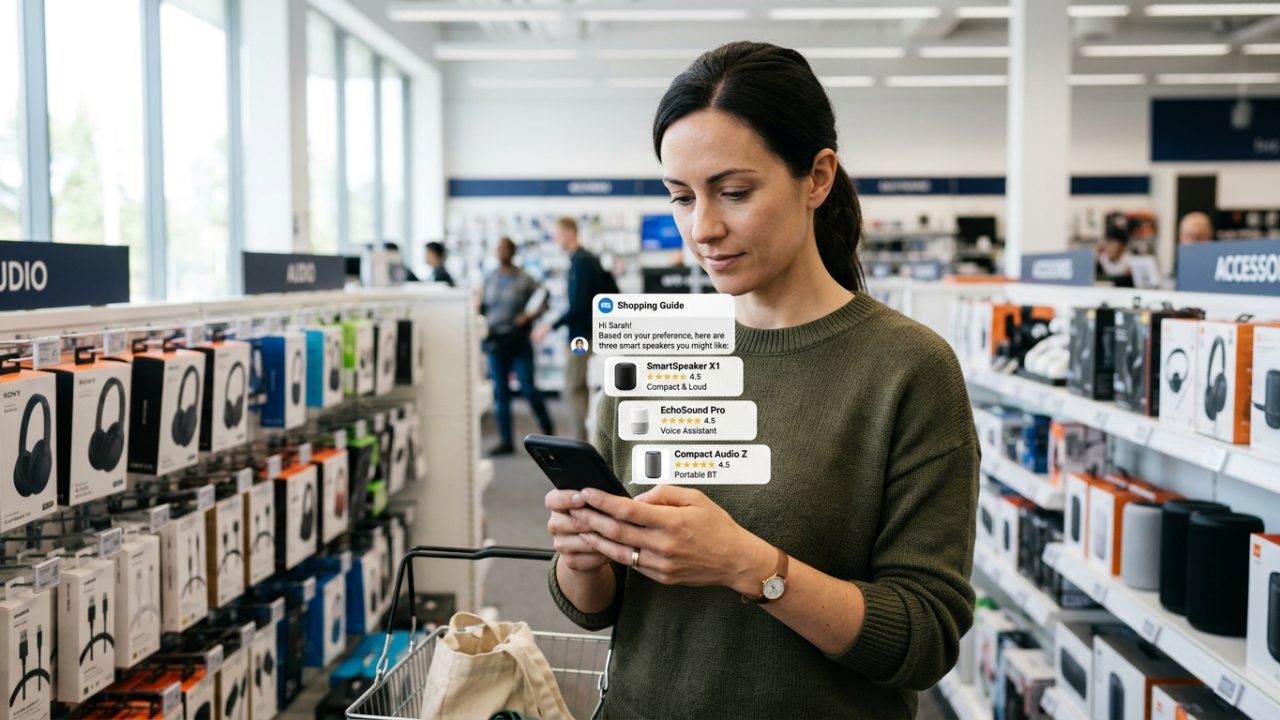
Quand un utilisateur demande à ChatGPT quel logiciel de facturation choisir, il reçoit trois noms. Ces trois noms n'ont pas été achetés, ils n'ont pas été classés par un algorithme de pertinence documenté, et personne chez l'éditeur cité n'a été prévenu. C'est le sujet de cette rubrique : une couche de recommandation s'est installée entre les marques et leur public, et elle fonctionne selon des règles que presque personne ne mesure.
Trois angles structurent nos publications. Le premier concerne les marques : comment elles se retrouvent recommandées ou ignorées, ce que valent les tentatives de forcer une mention, et pourquoi l'empreinte d'une marque dans les corpus d'entraînement compte autant que son site. Le deuxième porte sur les créateurs et les médias, qui voient une partie de leur trafic absorbé par des résumés produits à partir de leur propre travail, avec des accords de licence pour quelques-uns et rien pour les autres.
Le troisième angle est économique et social. L'attention se déplace, la valeur aussi. Un moteur qui répond à la place d'un site capte la relation avec l'utilisateur et laisse au producteur du contenu les coûts de production. Cette équation intéresse les régulateurs autant que les éditeurs, et les décisions prises en 2025 et 2026 sur le droit voisin, l'entraînement des modèles et la transparence des sources auront des effets durables.
Nous traitons ces sujets avec la même exigence que le reste du site : des faits datés, des sources identifiables, des chiffres qui viennent d'une mesure et pas d'une estimation de cabinet reprise de main en main. Quand une donnée est invérifiable, nous le disons plutôt que de l'arrondir.
Pour la mesure, le baromètre mensuel de la citation IA fournit la matière chiffrée qui manque au débat français.
 10:53
Le même article rédigé par quatre IA : le verdict
Avec Stéphane Delgado