DeepMind teste un modèle qui fusionne récupération et classement
Des chercheurs de Google DeepMind publient Autoregressive Ranking, un modèle unique capable de produire directement une liste ordonnée de documents. L'architecture en deux étages qui structure la recherche depuis dix ans pourrait à terme disparaître.
Google DeepMind a publié les résultats d'un modèle baptisé Autoregressive Ranking, ou ARR, qui produit directement une liste ordonnée de documents au lieu de passer par les deux étages habituels de la recherche d'information.
Comment fonctionne le classement aujourd'hui
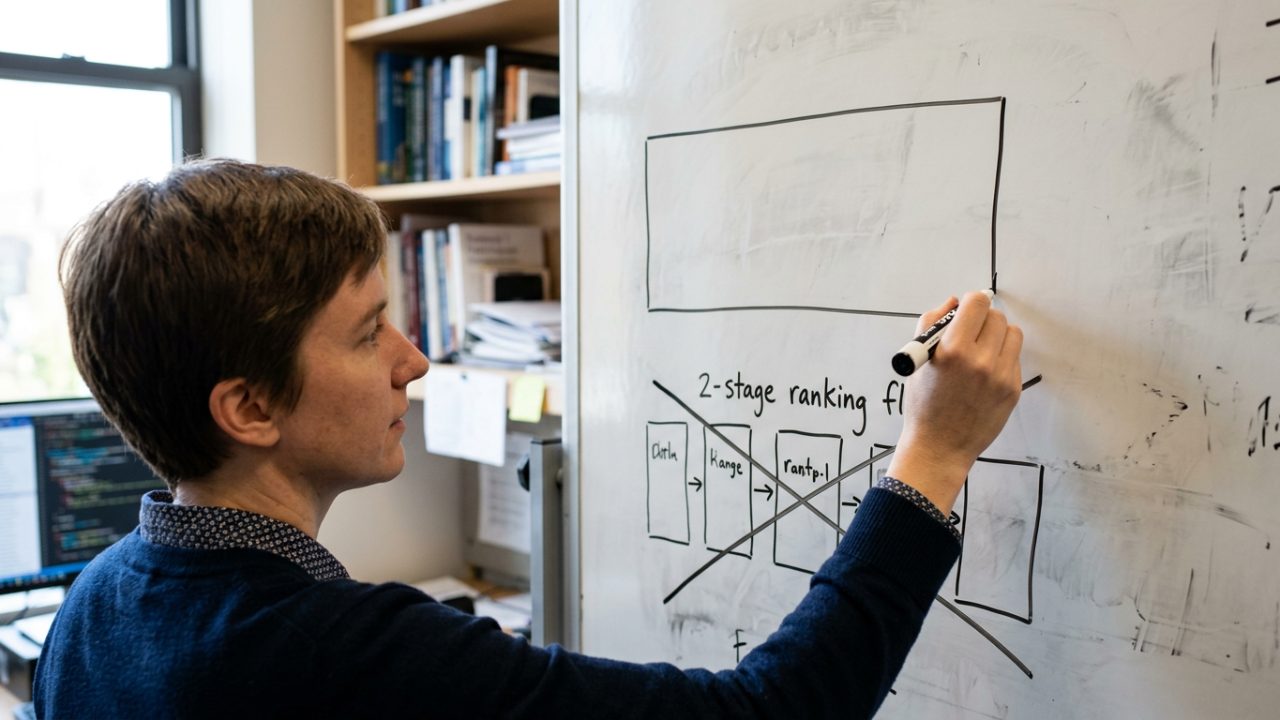
La recherche moderne fonctionne en deux temps. Un dual encoder transforme la requête et les documents en vecteurs, puis compare ces vecteurs pour ramener quelques centaines de candidats. C'est rapide, et grossier. Un cross encoder reprend ensuite ces candidats un par un avec la requête, et les ordonne finement. C'est précis, et coûteux.
Ce partage existe parce qu'aucun des deux ne sait faire le travail de l'autre à un coût acceptable. La limite connue du dual encoder est que la taille de ses vecteurs doit croître avec la taille du corpus pour conserver sa précision.
Ce que propose l'ARR
Le modèle unique génère la liste ordonnée comme un modèle de langage génère une phrase, jeton après jeton. Les chercheurs montrent qu'il peut résoudre des tâches de classement avec une dimension cachée constante, indépendante de la taille du corpus. C'est la promesse théorique la plus forte du papier.
L'entraînement repose sur une méthode appelée SToICaL, qui combine une pondération au niveau des éléments et une marginalisation par arbre de préfixes, pour apprendre au modèle quels documents doivent remonter et lesquels doivent descendre.
Les résultats, et ce qu'ils ne disent pas
Sur WordNet, l'ARR égale le cross encoder et dépasse nettement le dual encoder, avec une chute importante du taux d'erreur de classement. Sur ESCI Shopping, le jeu de données e-commerce d'Amazon, le tableau est plus nuancé : la performance globale tient, mais une variante dégrade le classement du document le plus pertinent. Autrement dit, la liste est meilleure dans l'ensemble et moins bonne en tête, ce qui est précisément l'endroit qui compte pour un marchand.
Ce que cela change, et quand
Rien à court terme. Il s'agit d'un travail de recherche, pas d'un déploiement. Aucun élément ne laisse penser que le classement de Google Search repose déjà sur cette architecture.
La portée est ailleurs. Une génération directe de la liste rapproche le classement de ce que fait déjà un moteur de réponse quand il choisit ses sources. Si l'étape de présélection disparaît, la notion de candidat repêché en deuxième rideau perd son sens, et ce sont les critères d'ordonnancement qui absorbent tout. Nous avions détaillé cette mécanique dans comment les moteurs de réponse choisissent leurs sources.
Pour une équipe SEO, le geste utile reste le même qu'avant la publication : rendre une page indiscutablement pertinente sur une intention, plutôt qu'acceptable sur dix.
Sources
- Search Engine Journal, Google DeepMind Develops New AI Search Ranking Model, 10 septembre 2026
- Publication de recherche Google DeepMind sur l'Autoregressive Ranking
Camille
Camille couvre le référencement technique pour aifluence : crawl, indexation, logs, performance.